Construire une application web qui accepte des vidéos paraît simple, jusqu’à l’arrivée du premier vrai fichier.
Une application web classique est conçue autour d’échanges courts. Le navigateur envoie une requête, le serveur lit ou modifie quelques données, puis renvoie rapidement une réponse. La vidéo change la donne. Les fichiers sont lourds. Leur traitement peut prendre plusieurs minutes. Chaque étape peut demander un environnement d’exécution différent. Et l’utilisateur peut fermer l’onglet en cours de route sans que le système soit autorisé à perdre le travail.
Quand j’ai commencé à construire CutCaption, je voulais que le produit donne l’impression d’être un éditeur dans le navigateur. Pourtant, l’architecture qui rend cette expérience possible ressemble moins à une application classique basée sur des formulaires qu’à un petit système de traitement média.
Cet article décrit le modèle que j’ai retenu : upload direct vers un stockage objet, control plane volontairement simple, jobs persistés, workers média serverless et remplaçables, fichiers dérivés pour l’édition et exports asynchrones. CutCaption sert d’étude de cas, mais ces principes s’appliquent à beaucoup de jeunes produits qui traitent de la vidéo, de l’audio, des documents ou d’autres fichiers volumineux.
La vidéo change la forme d’une application web
Un produit vidéo subit quatre contraintes qu’une application web classique peut souvent ignorer.
Essayer d’absorber ces quatre contraintes dans le serveur web principal produit un système fragile. Un gros upload entre en concurrence avec le trafic normal de l’API. Une commande média lente monopolise un processus qui devrait répondre aux utilisateurs. Un déploiement peut interrompre un traitement déjà lancé. Et mettre l’application à l’échelle revient aussi à multiplier des dépendances média coûteuses dont la plupart des requêtes n’ont jamais besoin.
Le changement architectural consiste à ne plus traiter le média comme une requête, mais comme un job persistant.
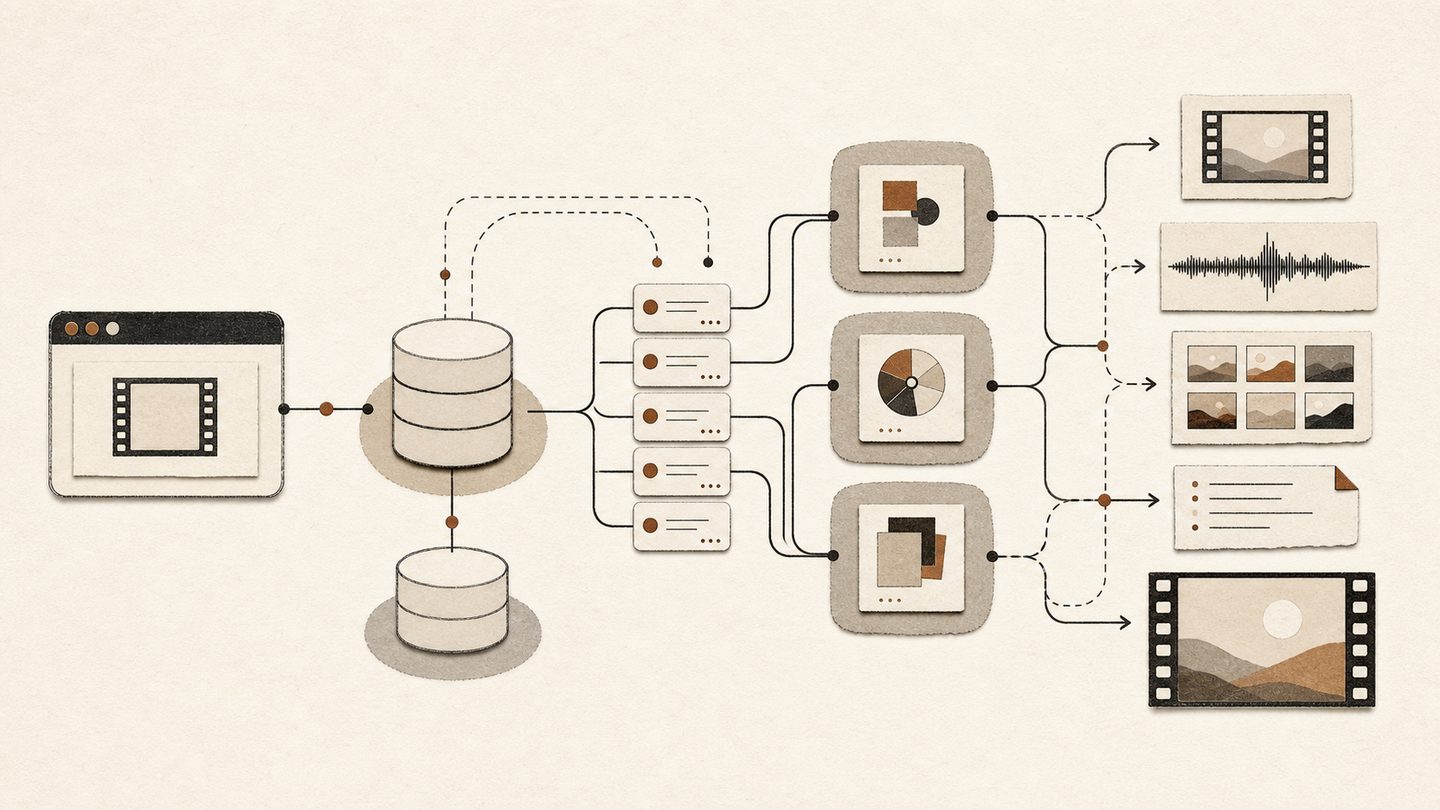
Vue d’ensemble du système
Je sépare le système en deux grandes parties.
Le control plane, ou plan de contrôle, possède l’état du produit. Il connaît les utilisateurs, les projets, les permissions, le document de sous-titres modifiable et le cycle de vie de chaque job. Il décide de ce qui peut se produire et enregistre ce qui s’est produit.
Le media plane exécute les traitements coûteux. Ses workers téléchargent les sources, lancent des outils ou des modèles, déposent les résultats et signalent l’issue du traitement. Un worker ne fait jamais autorité sur le projet : c’est un exécutant remplaçable qui prend en charge un job déjà enregistré.

Cette séparation compte davantage que le nombre de services. Une startup n’a pas besoin d’une constellation de microservices pour placer correctement cette frontière. Une application, une base de données relationnelle, un stockage objet et quelques types de workers empaquetés séparément suffisent déjà à isoler les responsabilités essentielles.
La base de données conserve les décisions et le cycle de vie. Le stockage objet transporte les octets. Les workers fournissent le calcul. Le navigateur porte l’interaction.
Uploader directement vers le stockage objet
La première décision de conception consiste à choisir où circulent les octets de la vidéo.
Le serveur applicatif doit toujours autoriser l’opération et garder une trace de ce qui va être uploadé. Il n’a pas à relayer chaque octet. Le navigateur demande donc à l’application une autorisation limitée, puis transfère directement le fichier vers le stockage objet.
Une fois l’objet accepté par le stockage, le navigateur demande à l’application de finaliser l’upload. Cette étape vérifie les informations nécessaires, puis enregistre le projet et son premier job dans une même transaction. Le traitement en arrière-plan ne peut commencer qu’après cette validation.

Cette approche a plusieurs conséquences utiles.
- Le serveur web n’est pas dimensionné en fonction de la plus grande vidéo acceptée.
- La progression de l’upload appartient au navigateur, là où l’utilisateur peut la suivre directement.
- Un upload interrompu peut reprendre sans garder une requête applicative ouverte.
- La même frontière de stockage fonctionne que le worker final s’exécute à côté de l’application ou sur une plateforme serverless.
Une distinction est essentielle : la présence d’un objet dans le stockage ne signifie pas encore que le produit l’a accepté. L’application ne doit pas afficher un projet prêt simplement parce que des octets existent. La finalisation est la transaction qui relie l’objet uploadé, l’enregistrement du projet et le premier job de traitement.
Un traitement long est un état, pas une requête
Une fois l’upload finalisé, l’application persiste un job de traitement. Cet enregistrement devient le point de coordination entre le produit et le worker qui finira par l’exécuter.
Un job minimal a besoin d’un identifiant, d’un type, d’un état courant, de références vers ses entrées et de suffisamment d’horodatages pour permettre la reprise. Il peut aussi contenir une progression et un motif d’échec dépourvu de données sensibles. Le schéma exact compte moins qu’une règle : le job doit exister indépendamment du processus qui tente de l’exécuter.
Un worker réserve un job en attente, obtient temporairement le droit de l’exécuter, puis démarre. Tant qu’il travaille, il renouvelle ce droit. S’il disparaît, un processus de recovery peut détecter l’expiration et décider de remettre le job en attente ou de le déclarer en échec.

Ce droit temporaire est généralement appelé un lease. Il empêche deux workers de croire indéfiniment qu’ils possèdent le même job actif. Un worker en retard peut terminer sa commande locale, mais il ne doit pas pouvoir écraser un résultat plus récent après avoir perdu son lease.
La finalisation doit aussi être idempotente. Si un worker dépose son résultat mais perd la réponse réseau au moment de signaler le succès, il ne sait pas si l’application a enregistré l’opération. Répéter le callback doit produire le même résultat, et non créer un second export ou faire repasser un job terminé en échec.
C’est l’une des différences concrètes entre une démo et un pipeline exploité en production. Le happy path est simple. Le système devient fiable lorsque les messages dupliqués, les réponses manquantes, les leases expirés et les annulations demandées par l’utilisateur ont tous un comportement défini.
Pourquoi les workers serverless conviennent à un jeune produit vidéo
La charge média est rarement régulière. Un worker peut rester inactif un moment, puis recevoir plusieurs jobs coûteux presque simultanément. Les différentes étapes peuvent aussi nécessiter des paquets système ou du matériel incompatibles.
Les workers serverless correspondent bien à ce profil de charge. Chaque type de worker peut avoir une image de conteneur conçue pour son rôle. L’ingestion a besoin d’outils d’inspection et de conversion média. La transcription nécessite un runtime dédié ou l’accès à un service speech-to-text. L’export a besoin d’un moteur de rendu et peut tirer parti d’une autre classe de calcul. La plateforme démarre des instances quand les jobs arrivent, puis les libère lorsque la demande retombe.
Le serveur applicatif reste ainsi petit et prévisible. Les dépendances d’exécution coûteuses restent également hors des requêtes web ordinaires.
Mais le serverless ne supprime pas les problèmes de systèmes distribués. Il change seulement l’acteur qui exploite les machines.
- Les cold starts existent.
- Les exécutions peuvent être retardées ou répétées.
- Les environnements d’exécution ont des limites.
- Les disques temporaires disparaissent.
- Un fournisseur peut renvoyer un résultat ambigu.
- La montée en charge peut devenir coûteuse sans limites définies au niveau du produit.
L’application conserve donc sa propre vision persistante du job. L’invocation du fournisseur est un moyen d’obtenir de la capacité de calcul, pas la source de vérité du produit.
Je sépare les workers selon leurs runtimes et leurs modes d’échec, plutôt que de créer un service pour chaque verbe. La préparation média, la transcription et l’export final sont des charges réellement différentes. Isoler une minuscule étape de métadonnées uniquement parce qu’elle porte un autre nom ajouterait de la coordination sans apporter d’isolation utile.
Conserver l’original, éditer avec des dérivés
Une vidéo uploadée est à la fois une entrée et un fichier source dont le système peut avoir de nouveau besoin. Elle doit être traitée différemment des fichiers que l’on peut régénérer.
L’original est la source de vérité. Le worker d’ingestion en produit des représentations plus légères, chacune adaptée à un usage précis. Un proxy facilite la lecture et la navigation dans le navigateur. Une piste audio extraite alimente la transcription. Les données de forme d’onde servent à la timeline. Les images de prévisualisation rendent le scrubbing et les listes de projets plus réactifs. Les sous-titres horodatés deviennent un document modifiable plutôt que des pixels incrustés dans la vidéo.

Ce graphe décrit la provenance des fichiers. Il permet de répondre à des questions opérationnelles utiles :
- Quels fichiers doivent être conservés ?
- Lesquels peuvent être supprimés puis régénérés ?
- Quelle étape a produit un résultat corrompu ?
- L’éditeur peut-il se rouvrir si l’original est temporairement indisponible ?
- Un export final peut-il toujours atteindre la qualité attendue par l’utilisateur ?
La base de données stocke les identités, les relations, les états et les métadonnées. Elle ne doit pas devenir un entrepôt de gros payloads binaires. Les workers s’échangent des références d’objets via le job et déplacent les médias eux-mêmes par le stockage objet.
Le stockage objet joue donc le rôle de data plane commun entre les différents environnements de calcul. Un worker n’a pas besoin de partager un système de fichiers local avec l’application. Il lui suffit d’avoir l’autorisation de lire les entrées déclarées et d’écrire les sorties prévues.
Le navigateur observe le travail au lieu de l’attendre
Le navigateur ne doit jamais garder une requête ouverte pendant toute la durée d’un job média.
Après la finalisation, l’application peut immédiatement renvoyer le projet et son état courant. L’interface indique que le traitement est actif et demande périodiquement un état plus récent. Le même état peut apparaître dans une liste de projets, une vue d’activité ou un espace de notifications. Fermer l’éditeur n’annule pas le job, sauf si l’utilisateur le demande explicitement.
Cela peut sembler être un petit détail d’interface, mais c’est une autre frontière architecturale. Le navigateur est un client de l’état persistant, pas le propriétaire du processus.
Le polling suffit souvent pour un jeune produit. Il est simple, observable et reprend facilement après la mise en veille ou la reconnexion d’un onglet. Des mises à jour en push peuvent être ajoutées plus tard, lorsque leur coût opérationnel se justifie. Le modèle de job sous-jacent n’a pas besoin de changer.
Une fois les fichiers dérivés nécessaires prêts, l’éditeur charge le proxy, la forme d’onde, les images de prévisualisation et le document de sous-titres. L’essentiel de l’édition s’effectue alors sur des fichiers conçus pour l’interaction plutôt que sur le lourd fichier original.
Chaque étape possède un état visible. L’utilisateur n’a pas à deviner si un indicateur signifie « encore en cours », « bloqué » ou « en échec depuis trois minutes ».
L’export est lui aussi un job persistant
L’export suit la même architecture dans le sens inverse.
L’éditeur commence par enregistrer le document de sous-titres courant. Pour cette révision précise, il produit ensuite une spécification de rendu — une description compacte et déterministe de l’apparence de chaque sous-titre et du moment où il doit apparaître — puis demande à l’application de créer un job d’export. Le worker d’export télécharge le média source et les paramètres de rendu, produit la vidéo finale, la dépose dans le stockage objet et publie le résultat.
L’application reste responsable de l’état du projet, des règles produit et du lien persistant entre la demande et le fichier obtenu. Le worker, lui, rend exactement le job qu’il a pris en charge.
C’est aussi ici que la cohérence de l’aperçu devient importante. L’aperçu dans le navigateur et la vidéo finale s’exécutent dans des environnements différents. Réimplémenter les règles de style dans le worker d’export créerait deux moteurs de rendu qui finiraient par diverger. CutCaption traite donc la spécification de rendu comme un contrat partagé entre l’aperçu et l’export. L’aperçu rapide peut optimiser certaines mises à jour, mais une reconstruction canonique complète reste la référence en matière de fidélité.
La leçon utile ne concerne ni le format de sous-titres ni la bibliothèque utilisée dans le navigateur. Elle concerne la frontière : les décisions visuelles doivent être fixées avant que les environnements d’aperçu et d’export divergent.
L’échec fait partie de la conception
Un pipeline média doit supposer que chaque frontière peut échouer indépendamment.
L’annulation est également coopérative. Supprimer un projet ou annuler un job doit retirer au worker le droit de valider de nouveaux progrès. Un worker bien conçu détecte la perte de son lease et arrête ses sous-processus coûteux. L’interface ne doit pas promettre que toute opération externe disparaîtra instantanément.
L’observabilité doit suivre la même frontière. Il faut journaliser les transitions d’état, les durées, le nombre de tentatives et des catégories d’échec nettoyées. En revanche, recopier des médias privés ou des sous-titres complets dans les logs simplement parce que c’est pratique est une mauvaise habitude.
La reprise peut, dans la plupart des cas, s’exécuter périodiquement. Elle repère les jobs qui auraient dû avancer, répare les cas sûrs et rend explicites les échecs définitifs. C’est moins spectaculaire qu’une nouvelle fonctionnalité média, mais c’est ce qui transforme un pipeline en produit exploitable.
Ce que je ne construirais pas en premier
Il est facile de regarder cette architecture et d’en conclure qu’elle exige un grand broker de messages, un orchestrateur de conteneurs, du streaming d’événements et un service séparé pour chaque étape.
Cela pourra devenir pertinent. Ce n’est pas le besoin de départ.
Pour un jeune produit, une base de données relationnelle peut contenir les jobs persistés. Les workers peuvent les réserver via une interface applicative étroite. Un processus de recovery périodique peut reprendre ceux dont le lease a expiré. Le stockage objet peut servir de data plane média. Un petit nombre d’images de workers suffit à séparer les environnements réellement différents.
Cette conception est volontairement conservatrice. Elle s’appuie sur le modèle transactionnel de la base de données dont le produit a déjà besoin et évite d’introduire trop tôt de nouveaux modes d’échec.
Lorsque la demande augmente, chaque frontière peut évoluer séparément :
- Le mécanisme de réservation en base de données peut être remplacé par une queue dédiée.
- Le polling peut recevoir des réveils déclenchés par des événements.
- Un même pool de workers peut être séparé selon la priorité ou le matériel.
- Les fichiers dérivés peuvent être distribués par des caches régionaux.
- Le processus de reprise peut évoluer à mesure que les incidents réels révèlent de nouveaux besoins.
L’essentiel est que ces évolutions remplacent un mécanisme derrière une frontière, au lieu d’imposer une réécriture du produit. Le navigateur continue d’observer l’état du projet. L’application continue de posséder le job. Le worker continue de consommer des références d’objets et de publier un résultat.
Un point de départ concret
Si je construisais une autre startup média, je commencerais par les règles suivantes :
- Garder le plan de contrôle simple. Placer les décisions produit et l’état persistant dans l’application et la base de données relationnelle.
- Uploader directement les gros fichiers vers le stockage objet. L’application autorise et finalise l’opération, mais ne relaie pas le contenu.
- Persister le job avant de déclencher le calcul. Le calcul est remplaçable ; l’obligation, elle, doit déjà être enregistrée.
- Rendre les workers sans état et spécialisés. Les entrées et les sorties vivent dans le stockage objet, pas sur une machine particulière.
- Modéliser explicitement la propriété des jobs. Les leases, la finalisation idempotente et la reprise des jobs expirés doivent exister avant que la montée en charge rende leur absence douloureuse.
- Séparer les originaux des dérivés. Savoir ce qui est irremplaçable, ce qui est optimisé pour l’interaction et ce qui peut être régénéré.
- Laisser l’interface observer l’état. Ne pas lier l’onglet de l’utilisateur à la durée de vie d’un calcul distant.
- Ajouter de l’infrastructure à partir de faits observés. Conserver les frontières et remplacer le mécanisme qui se trouve derrière lorsque la version simple atteint ses limites.
Pour l’utilisateur, CutCaption ressemble à une seule application dans le navigateur. Derrière cette surface, l’upload, la préparation média, la transcription, l’édition et l’export s’exécutent selon des durées de vie et dans des environnements de calcul différents.
Le système fonctionne parce que ces parties n’ont pas besoin de partager le même processus. Elles partagent des contrats : une référence d’objet, l’état persistant d’un job, une règle de propriété et un résultat défini.
C’est cette architecture que je réutiliserais pour le prochain produit média.